Méthodologie IG1252 : comment le niveau d'autonomie d'un réseau est noté
IG1252 est la méthodologie du TM Forum qui transforme la notation des tâches en niveau d'autonomie réseau pour chaque scénario évalué. Chaque tâche est notée de L0 à L5 à travers les étapes IAADE, puis les notes sont combinées en un résultat de scénario exprimé en Lbase, Lextra et Lscenario.
Cette page explique la logique avec nos propres mots. IG1252 est réservé aux membres du TM Forum : nous ne le reproduisons pas et renvoyons à la page officielle IG1252 v1.2.0 du TM Forum.
Ce que définit IG1252
Le TM Forum décrit les réseaux autonomes sur une échelle qui va de L0, l'exploitation manuelle, à L5, le réseau entièrement autonome (voir les niveaux AN de L0 à L5). Une échelle ne dit pas comment noter un réseau réel. C'est le rôle d'IG1252, l'Autonomous Network Levels Evaluation Methodology. Selon la page des ressources AN du TM Forum, la version en vigueur, v1.2.0, a été approuvée le 16 juin 2023.
Le Level 4 industry blueprint du TM Forum (novembre 2024) résume ce que couvre la méthodologie : la démarche d'évaluation et ses étapes, les critères d'évaluation des tâches et la méthode de notation. Concrètement, IG1252 répond à trois questions :
- Qu'évalue-t-on ? L'objet de l'évaluation est toujours le scénario (par exemple la gestion des pannes RAN), jamais un réseau entier. Le TM Forum parle de scénarios à haute valeur (HVS).
- Comment note-t-on une tâche ? Chaque tâche est confrontée aux critères de niveau, étape par étape, selon le cycle IAADE.
- Comment combine-t-on les notes ? Les notes des tâches remontent en un résultat unique pour le scénario.
IG1252 fonctionne avec ANLET, l'Autonomous Network Level Evaluation Tool. ANLET fournit les questionnaires par scénario, publiés sous forme de tableurs dans la série GB1059 ; IG1252 en donne la méthode. Depuis juin 2025, le service ANLAV du TM Forum ajoute une troisième étape : des évaluateurs certifiés peuvent soumettre une évaluation ANLET à une validation indépendante, comme l'explique TM Forum Inform.
Notation par tâche et par sous-scénario
Chaque scénario est découpé en sous-scénarios qui regroupent des tâches liées. La tâche est la plus petite unité qui reçoit un niveau.
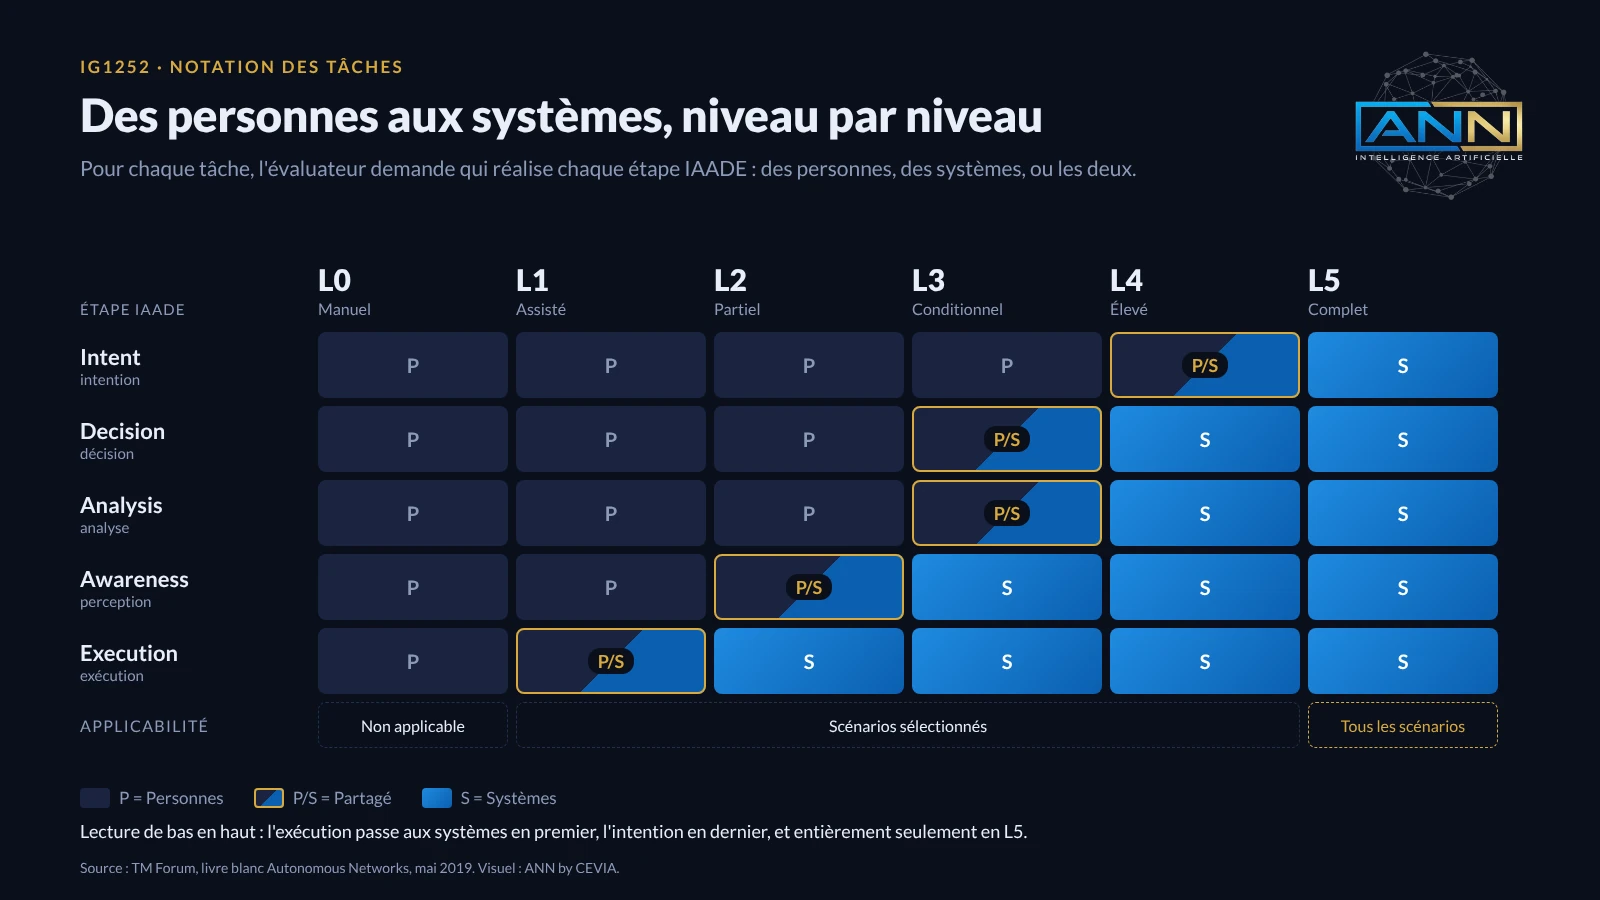
Pour chaque tâche, l'évaluateur examine les cinq étapes IAADE : Intent, Awareness, Analysis, Decision et Execution. La question est la même à chaque étape : le travail est-il fait par des personnes, par des systèmes, ou par les deux ? Plus les systèmes prennent d'étapes en charge, plus le niveau monte. L'exécution est en général automatisée en premier. L'intention est confiée en dernier, et entièrement seulement au niveau L5.
Toutes les tâches ne pèsent pas autant. Le blueprint indique que les questionnaires d'évaluation s'appuient sur les grilles d'organismes comme le 3GPP et l'ETSI, complétées par une pondération et des critères de notation détaillés. Sa question d'exemple porte un poids de 5 % pour la collecte de données. Une tâche plus importante pour le scénario compte donc davantage dans le résultat.
Au sein d'un sous-scénario, les notes montrent où le travail est déjà automatisé et où il repose encore sur des personnes. D'un sous-scénario à l'autre, elles se combinent en résultat de scénario.
Le blueprint reconnaît aussi des limites. En novembre 2024, la notation détaillée par domaine et par scénario n'était pas encore entièrement normalisée, et les premiers résultats du pilote montraient que les questionnaires devaient être affinés pour permettre une notation comparable. Un niveau se lit donc toujours avec son scénario, son questionnaire et ses preuves.
Lbase, Lextra et Lscenario
IG1252 exprime le résultat de chaque scénario en trois valeurs. Avec nos mots :
| Valeur | Ce qu'elle indique |
|---|---|
| Lbase | Le niveau de base atteint par les tâches du scénario. La capacité la plus faible le retient. |
| Lextra | Un crédit supplémentaire pour les tâches qui dépassent déjà ce niveau de base. |
| Lscenario | Le niveau résultant du scénario, qui combine Lbase et Lextra. |
Pourquoi deux composantes ? Une simple moyenne masquerait les points faibles. Prenons le cas où la plupart des tâches tournent au niveau L4, mais où la prise en charge des alarmes reste manuelle. Une moyenne pourrait frôler le niveau 4, alors que l'exploitation dépend encore de personnes à cette étape. Séparer la base du crédit supplémentaire garde les deux faits visibles : le niveau sur lequel tout le scénario peut compter, et les progrès déjà faits au-dessus.
C'est aussi pourquoi les résultats se lisent souvent avec des décimales. Lors de la phase 2 du pilote décrit dans le blueprint, le score moyen en gestion des pannes était de 2,5 sur le cœur de réseau et de 2,8 sur le RAN : la plupart des opérateurs se situaient entre le niveau 2 et le niveau 3.
Les règles exactes de calcul de Lbase et de Lextra, poids et seuils compris, figurent dans IG1252 et dans chaque questionnaire ANLET. Nous ne les reproduisons pas ici.
Exemple chiffré (fictif)
L'exemple ci-dessous a été construit par CEVIA pour montrer le mécanisme. Le sous-scénario, les tâches, les poids et les niveaux sont inventés ; les résultats sont ceux qu'ANN calculerait pour ces réponses. Ce n'est pas un extrait d'IG1252 ni d'un questionnaire ANLET.
Prenons un sous-scénario fictif, « Traitement des alarmes », avec cinq tâches :
| Tâche (fictive) | Poids | Niveau |
|---|---|---|
| Collecter les alarmes de tous les équipements | 15 % | L4 |
| Filtrer et dédoublonner les alarmes | 20 % | L3 |
| Corréler les alarmes avec une cause probable | 30 % | L3 |
| Décider de l'action corrective | 20 % | L2 |
| Exécuter et vérifier la correction | 15 % | L3 |
Lecture étape par étape :
- Lbase. La tâche la plus faible, la décision de l'action corrective, est au niveau L2. Le niveau de base est donc le niveau 2 : c'est ce sur quoi tout le sous-scénario peut compter.
- Lextra. Les tâches qui représentent 80 % du poids fonctionnent déjà au-dessus de L2. Le crédit supplémentaire vaut donc 0,8.
- Lscenario. La combinaison des deux donne 2,8 : niveau 2, proche du niveau 3.
Supposons maintenant que l'équipe fasse passer la tâche de décision au niveau L3. La base passe au niveau 3, et seule la collecte des alarmes (15 % du poids) reste au-dessus. Le résultat devient 3,15.
La leçon est claire. Faire passer la collecte des alarmes de L4 à L5 ne changerait presque rien au résultat. Relever la tâche la plus faible change le niveau de base. C'est tout l'intérêt de la liste des écarts : elle désigne les tâches qui freinent le scénario.
Pourquoi « Non évalué » ne vaut jamais zéro
Une réponse manquante n'est pas une mauvaise réponse. Si une tâche n'a pas encore été notée, la compter comme L0 fausserait le résultat. Dans l'exemple ci-dessus, la tâche « Exécuter et vérifier la correction », non notée et comptée comme L0, ferait tomber la base au niveau 0, alors que rien n'indique que cette tâche est manuelle.
Une tâche sans réponse est donc marquée Non évalué et sortie du calcul, au lieu d'être notée zéro. Dans ANN, elle porte un badge gris « Non évalué », jamais un zéro ni un statut d'échec. Tant qu'un sous-scénario est incomplet, le score global affiche lui aussi « Non évalué » plutôt qu'un chiffre, pour éviter un résultat trompeur.
La même prudence vaut pour l'IA. Dans ANN, une réponse pré-remplie par l'IA ne compte dans aucun score tant qu'une personne ne l'a pas validée ou n'a pas choisi un niveau elle-même.
Comment ANN applique IG1252
ANN utilise IG1252 comme méthode de notation derrière ses questionnaires :
- Questionnaires par scénario. Chacun des scénarios actuellement disponibles dans ANN, listés sur la page des scénarios, est organisé en onglets par sous-scénario, puis par tâche, notée de L0 à L5 à travers les étapes IAADE. Par exemple la gestion des pannes RAN (GB1523A) ou l'optimisation de l'efficacité énergétique RAN (GB1526A).
- Résultat du scénario. L'écran de résultats affiche Lbase, Lextra et Lscenario selon IG1252, un radar de maturité IAADE et la liste des écarts par sous-scénario. Cette liste alimente la feuille de route, dont la première phase consiste à combler les écarts critiques.
- Source de chaque questionnaire. Chaque scénario indique l'origine de son questionnaire : un rapport ANLAV réel quand il existe, ou une reconstruction documentée par CEVIA à partir des questionnaires publiés par le TM Forum. Une reconstruction n'est jamais présentée comme une table officielle du TM Forum.
- Des preuves séparées du score. Chaque tâche peut recevoir des preuves déclaratives ou techniques. ANN affiche un taux de couverture des preuves où une preuve technique compte entièrement et une preuve déclarative seule compte pour moitié, avec un seuil de couverture de 80 % par défaut. Cette pondération est une méthode CEVIA, pas une règle du TM Forum, et elle ne modifie jamais Lscenario.
Un niveau auto-évalué, même calculé avec soin, n'est pas une validation. Dans le cadre d'ANLAV, un évaluateur certifié soumet l'évaluation et le TM Forum la valide. Pour savoir ce que cela demande, lisez comment se préparer à ANLAV.
À lire aussi : les niveaux AN de L0 à L5 pour l'échelle elle-même, Qu'est-ce qu'ANLET ? pour les questionnaires, et le glossaire pour chaque terme de cette page.