IG1252-evaluatiemethodologie: zo wordt het autonomieniveau van een netwerk gescoord
IG1252 is de methodologie van TM Forum die de beoordeling van taken omzet in een autonomieniveau per scenario. Elke taak krijgt een niveau van L0 tot L5 via de IAADE-stappen, en die niveaus worden gecombineerd tot het scenarioresultaat in Lbase, Lextra en Lscenario.
Deze pagina legt de logica uit in onze eigen woorden. IG1252 is voorbehouden aan leden van TM Forum. We nemen het document dus niet over en verwijzen naar de officiële pagina van IG1252 v1.2.0 van TM Forum.
Wat IG1252 vastlegt
TM Forum beschrijft autonome netwerken op een schaal van L0, volledig handmatig beheer, tot L5, een volledig autonoom netwerk (zie AN-niveaus L0 tot L5). Een schaal zegt nog niet hoe je een echt netwerk beoordeelt. Daarvoor dient IG1252, de Autonomous Network Levels Evaluation Methodology. Volgens de pagina met AN-bronnen van TM Forum werd de huidige versie, v1.2.0, goedgekeurd op 16 juni 2023.
De Level 4 industry blueprint van TM Forum (november 2024) vat samen wat de methodologie omvat: de evaluatieaanpak en de werkstappen, de beoordelingscriteria per taak en de scoremethode. In de praktijk beantwoordt IG1252 drie vragen:
- Wat wordt beoordeeld? Het evaluatieobject is altijd het scenario, zoals RAN-storingsbeheer, nooit een volledig netwerk. TM Forum spreekt van high value scenarios (HVS).
- Hoe wordt een taak beoordeeld? Elke taak wordt stap voor stap via de IAADE-cyclus getoetst aan de niveaucriteria.
- Hoe worden de beoordelingen gecombineerd? De niveaus van de taken leiden tot één resultaat voor het scenario.
IG1252 werkt samen met ANLET, de Autonomous Network Level Evaluation Tool. ANLET levert de vragenlijsten per scenario, gepubliceerd als spreadsheets in de GB1059-reeks; IG1252 levert de methode erachter. Sinds juni 2025 voegt de ANLAV-dienst van TM Forum een derde stap toe: gecertificeerde evaluatoren kunnen een ANLET-evaluatie indienen voor onafhankelijke validatie, zoals TM Forum Inform meldt.
Scoring per taak en per subscenario
Elk scenario is opgedeeld in subscenario's die samenhangende taken groeperen. De taak is de kleinste eenheid die een niveau krijgt.
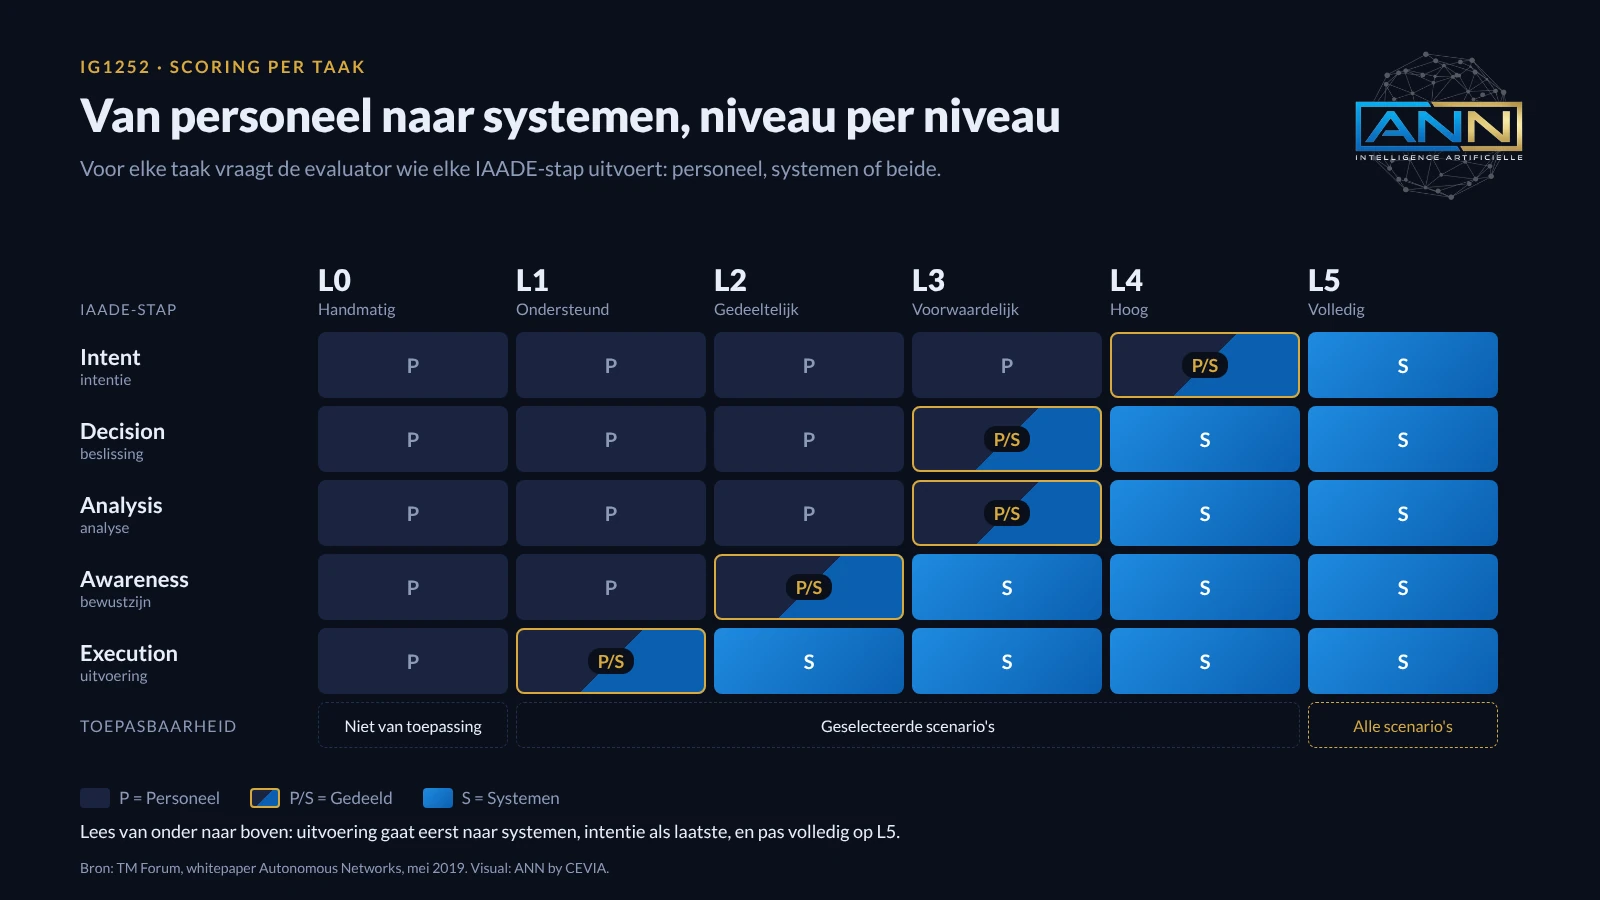
Voor elke taak bekijkt de evaluator de vijf IAADE-stappen: Intent, Awareness, Analysis, Decision en Execution. Bij elke stap is de vraag dezelfde: wordt het werk gedaan door mensen, door systemen of door beide? Hoe meer stappen systemen uitvoeren, hoe hoger het niveau. Uitvoering wordt meestal eerst geautomatiseerd. De intentie wordt als laatste overgedragen, en pas volledig op L5.
Niet alle taken wegen even zwaar. De blueprint legt uit dat de vragenlijsten steunen op de beoordelingskaders van organisaties als 3GPP en ETSI, aangevuld met een weging en gedetailleerde scorecriteria. De voorbeeldvraag krijgt een gewicht van 5 % voor gegevensverzameling. Een taak die zwaarder doorweegt voor het scenario, telt dus ook zwaarder in het resultaat.
Binnen elk subscenario tonen de niveaus waar het werk al geautomatiseerd is en waar mensen het nog dragen. Over de subscenario's heen worden ze gecombineerd tot het scenarioresultaat.
De blueprint is ook eerlijk over de grenzen. In november 2024 was de gedetailleerde scoring per domein en per scenario nog niet volledig gestandaardiseerd, en de eerste resultaten van de pilot toonden dat de vragenlijsten verfijnd moesten worden om vergelijkbare scores mogelijk te maken. Een niveau lees je daarom altijd samen met het scenario, de vragenlijst en het bewijs.
Lbase, Lextra en Lscenario
IG1252 drukt het resultaat van elk scenario uit in drie waarden. In onze eigen woorden:
| Waarde | Wat ze aangeeft |
|---|---|
| Lbase | Het basisniveau dat de taken van het scenario halen. De zwakste capaciteit houdt het tegen. |
| Lextra | Extra krediet voor taken die al boven dat basisniveau werken. |
| Lscenario | Het resulterende niveau van het scenario, dat Lbase en Lextra combineert. |
Waarom twee delen? Een gewoon gemiddelde zou de zwakke punten verbergen. Stel dat de meeste taken op L4 draaien, maar dat het binnenhalen van alarmen nog handmatig gebeurt. Een gemiddelde kan dan dicht bij niveau 4 uitkomen, terwijl de dagelijkse operatie op die stap nog van mensen afhangt. Door de basis en het extra krediet te scheiden blijven beide feiten zichtbaar: het niveau waarop het hele scenario kan rekenen, en de vooruitgang die daarboven al geboekt is.
Daarom worden resultaten vaak met decimalen gelezen. In fase 2 van de pilot uit de blueprint was de gemiddelde score voor storingsbeheer 2,5 in het kernnetwerk en 2,8 in het RAN: de meeste operatoren zaten tussen niveau 2 en niveau 3.
De precieze rekenregels voor Lbase en Lextra, met gewichten en drempels, staan in IG1252 en in elke ANLET-vragenlijst. We nemen ze hier niet over.
Een rekenvoorbeeld (fictief)
Het voorbeeld hieronder is door CEVIA opgesteld om het mechanisme te tonen. Het subscenario, de taken, de gewichten en de niveaus zijn verzonnen; de resultaten zijn die welke ANN voor deze antwoorden zou berekenen. Het is geen uittreksel uit IG1252 of uit een ANLET-vragenlijst.
Neem als voorbeeld het fictieve subscenario "Alarmafhandeling", met vijf taken:
| Taak (fictief) | Gewicht | Niveau |
|---|---|---|
| Alarmen verzamelen van alle netwerkelementen | 15 % | L4 |
| Alarmen filteren en ontdubbelen | 20 % | L3 |
| Alarmen koppelen aan een waarschijnlijke oorzaak | 30 % | L3 |
| Beslissen over de corrigerende actie | 20 % | L2 |
| De correctie uitvoeren en controleren | 15 % | L3 |
Stap voor stap gelezen:
- Lbase. De zwakste taak, de beslissing over de corrigerende actie, staat op L2. Het basisniveau is dus niveau 2: daarop kan het hele subscenario rekenen.
- Lextra. Taken die samen 80 % van het gewicht vertegenwoordigen, werken al boven L2. Het extra krediet bedraagt dus 0,8.
- Lscenario. Samen geeft dat 2,8: niveau 2, dicht bij niveau 3.
Stel nu dat het team de beslissingstaak naar L3 tilt. De basis stijgt naar niveau 3, en alleen het verzamelen van alarmen (15 % van het gewicht) blijft erboven. Het resultaat wordt 3,15.
De les is duidelijk. Het verzamelen van alarmen van L4 naar L5 brengen, verandert het resultaat nauwelijks. De zwakste taak optillen verandert het basisniveau. Daar dient de lijst met hiaten voor: ze wijst de taken aan die het scenario tegenhouden.
Waarom "Niet beoordeeld" nooit nul is
Een ontbrekend antwoord is geen slecht antwoord. Als een taak nog niet beoordeeld is, zou ze als L0 tellen het resultaat vertekenen. In het voorbeeld hierboven zou de taak "De correctie uitvoeren en controleren", geteld als L0, de basis naar niveau 0 trekken, terwijl niets erop wijst dat die taak handmatig gebeurt.
Een taak zonder antwoord wordt daarom als Niet beoordeeld gemarkeerd en buiten de berekening gelaten, in plaats van als nul te tellen. In ANN krijgt ze een grijze badge "Niet beoordeeld", nooit een nul of een mislukte status. Zolang een subscenario onvolledig is, toont ook de totaalscore "Niet beoordeeld" in plaats van een getal, om een misleidend cijfer te vermijden.
Dezelfde voorzichtigheid geldt voor AI. In ANN telt een door AI vooraf ingevuld antwoord in geen enkele score mee zolang een persoon het niet heeft gevalideerd of zelf een niveau heeft gekozen.
Hoe ANN IG1252 toepast
ANN gebruikt IG1252 als scoremethode achter zijn vragenlijsten:
- Vragenlijsten per scenario. Elk van de scenario's die momenteel in ANN beschikbaar zijn, te vinden op de scenariopagina, is ingedeeld in tabbladen per subscenario en daarna per taak, beoordeeld van L0 tot L5 via de IAADE-stappen. Voorbeelden zijn RAN-storingsbeheer (GB1523A) en optimalisatie van de RAN-energie-efficiëntie (GB1526A).
- Scenarioresultaat. Het resultatenscherm toont Lbase, Lextra en Lscenario volgens IG1252, een IAADE-maturiteitsradar en een lijst met hiaten per subscenario. Die lijst voedt de roadmap, waarvan de eerste fase het dichten van de kritieke hiaten is.
- Bron van elke vragenlijst. Elk scenario vermeldt waar de vragenlijst vandaan komt: een echt ANLAV-rapport als dat bestaat, of een reconstructie die CEVIA heeft gedocumenteerd op basis van gepubliceerde vragenlijsten van TM Forum. Een reconstructie wordt nooit voorgesteld als een officiële tabel van TM Forum.
- Bewijs, los van de score. Elke taak kan declaratief of technisch bewijs krijgen. ANN toont een dekkingsgraad van het bewijs waarin technisch bewijs volledig telt en declaratief bewijs alleen voor de helft, met een standaard dekkingsdrempel van 80 %. Die weging is een CEVIA-methode, geen regel van TM Forum, en ze verandert Lscenario nooit.
Een zelf beoordeeld niveau, ook als het zorgvuldig berekend is, is geen validatie. Binnen ANLAV dient een gecertificeerde evaluator de evaluatie in en valideert TM Forum ze. Wat daarvoor nodig is, lees je in voorbereiden op ANLAV.
Lees ook: AN-niveaus L0 tot L5 voor de schaal zelf, Wat is ANLET? voor de vragenlijsten, en de woordenlijst voor elke term op deze pagina.